Guia completo de Monitoramento e observabilidade
Saber o que está acontecendo antes que o usuário reclame
· 3 min de leitura · 6 visualizações
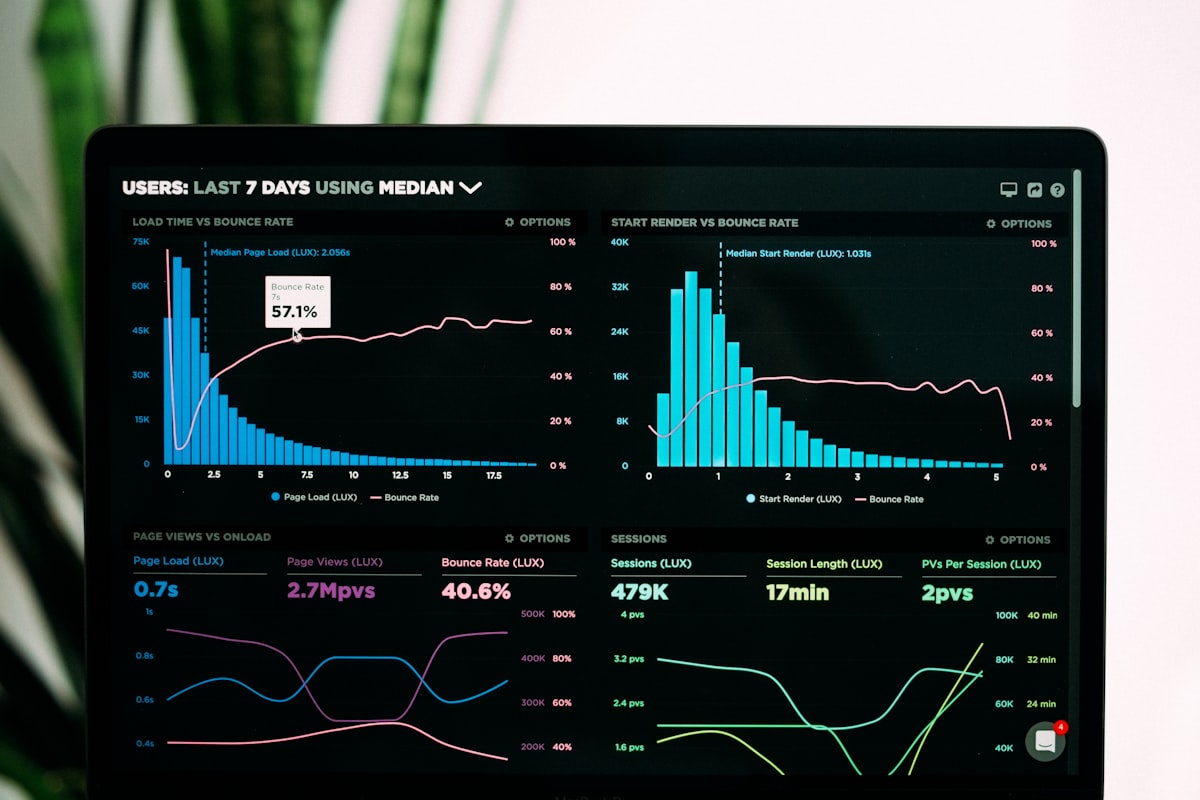
Se você ainda não tem clareza sobre Monitoramento e observabilidade, este guia resume o essencial sem enrolação.
Observabilidade vai além de monitorar se um sistema está "no ar" — envolve métricas, logs e rastreamento distribuído que permitem entender por que algo está lento ou falhando, não só que está falhando.
O que você precisa saber
- Alertas devem ser acionáveis — alertas que ninguém investiga porque "sempre disparam à toa" acabam sendo ignorados.
- Rastreamento distribuído ajuda a identificar exatamente qual serviço está causando lentidão em uma arquitetura de microsserviços.
- Dashboards focados nas métricas que importam para o negócio são mais úteis do que painéis genéricos com dados demais.
- Logs estruturados (formato consistente, pesquisável) economizam tempo de diagnóstico comparado a logs de texto livre.
- Definir SLOs (objetivos de nível de serviço) claros ajuda a equipe a saber quando um problema é realmente crítico.
Um sistema bem observado permite diagnosticar um problema em minutos; um sistema mal observado transforma cada incidente em uma investigação do zero.
Vale reforçar: dominar Monitoramento e observabilidade não é acumular definições, é saber reconhecer quando o tema se aplica a um problema real na sua rotina de trabalho. Equipes que tratam esse tipo de conteúdo como referência de consulta — voltando a ele quando a dúvida aparece na prática — aproveitam muito mais do que quem lê uma vez e segue em frente.
Essa diferença importa na prática porque sistemas modernos, especialmente os baseados em containers e microsserviços, falham de formas mais difíceis de prever do que um servidor monolítico único. Uma lentidão no checkout de uma loja virtual pode ter origem em um serviço de pagamento, no banco de dados ou na rede entre eles — e só um trace distribuído mostra claramente onde o tempo foi gasto. Ferramentas como Prometheus e Grafana para métricas, e soluções como Jaeger para tracing, tornaram-se padrão de facto nesse ecossistema, como cataloga a lista de projetos da CNCF.
Para pequenas empresas, mesmo um monitoramento básico — uptime do site, tempo de resposta e alertas por e-mail ou WhatsApp quando algo cai — já reduz drasticamente o tempo de reação a problemas, evitando que um cliente seja quem avisa que o sistema está fora do ar.
Perguntas frequentes
- Por onde começar com Monitoramento e observabilidade?
- Alertas devem ser acionáveis — alertas que ninguém investiga porque "sempre disparam à toa" acabam sendo ignorados.
- Por onde começar com Monitoramento e observabilidade?
- Rastreamento distribuído ajuda a identificar exatamente qual serviço está causando lentidão em uma arquitetura de microsserviços.
Esta matéria faz parte da cobertura de monitoramento e observabilidade assinada por Diego Almeida na Revista SmartWeb — acompanhe as próximas colunas sobre o tema para aprofundar cada um dos pontos levantados aqui.
Fontes e leitura complementar
Baixe gratuitamente o Panorama da Tecnologia nas Pequenas e Médias Empresas Brasileiras — 2026/2027
Dados reais sobre IA, automação, segurança e gestão nas pequenas e médias empresas brasileiras.
Quero o relatório completo
Sobre o autor
Diego Almeida
Diego Almeida escreve sobre cloud, DevOps e infraestrutura, sempre com o olho no custo real e na operação do dia a dia — não só no que funciona bem em uma palestra.
Continue explorando
Guia prático de Eficiência energética em infraestrutura para equipes enxutas
Um roteiro para entender decisões, riscos e primeiros passos sem transformar o tema em um projeto interminável. Foco: reduzir desperdício junto com custo e capacidade ociosa.
Diego Almeida · 11/10/2026
Reforma Tributária em 2027: sua empresa está preparada para as novas regras?
Veja o que pequenos negócios precisam revisar com a contabilidade e com o fornecedor do sistema de gestão.
Beatriz Nogueira · 12/10/2026
Guia prático de LGPD no ciclo de vida do cliente para equipes enxutas
Um roteiro para entender decisões, riscos e primeiros passos sem transformar o tema em um projeto interminável. Foco: coletar e manter apenas dados com finalidade definida.
Rafael Tanaka · 11/10/2026 · Exclusivo
Comentários (0)
Entre para deixar um comentário.
Nenhum comentário ainda — seja o primeiro a comentar.